Alibaba Resmi Rilis Qwen4-Max Secara Umum: Arsitektur MoE 2,4 Triliun Parameter dengan Biaya Tugas Turun 62 Persen · Bandung Quality
16 November 2026·4 menit baca
Alibaba Resmi Rilis Qwen4-Max Secara Umum: Arsitektur MoE 2,4 Triliun Parameter dengan Biaya Tugas Turun 62 Persen
Persaingan model kecerdasan buatan (AI) generasi mutakhir kembali memanas pada Senin (16/11/2026). Tim Qwen dari Alibaba resmi meluncurkan model andalan terbarunya, Qwen4-Max, ke…
Persaingan model kecerdasan buatan (AI) generasi mutakhir kembali memanas pada Senin (16/11/2026). Tim Qwen dari Alibaba resmi meluncurkan model andalan terbarunya, Qwen4-Max, ke tahap ketersediaan umum (general availability/GA) melalui QwenCloud, Qwen Studio, QwenWork, dan Qoder—hanya lima hari setelah membuka fase pratinjau terbatas pada 11 November lalu.
Peluncuran ini langsung menjadi perbincangan utama di komunitas pengembang AI global di Reddit dan X sepanjang hari ini. Pasalnya, Alibaba tidak sekadar mempertahankan skala 2,4 triliun parameter dengan jendela konteks 1 juta token, tetapi juga merombak arsitektur internal Mixture-of-Experts (MoE) sehingga jumlah parameter aktif menyusut 25 persen menjadi 71 miliar parameter per token dan memangkas rata-rata biaya penyelesaian tugas hingga 62 persen.
Bedah Arsitektur Baru Qwen4-Max: Lebih Hemat Parameter, Lebih Stabil
Alih-alih hanya memperbesar ukuran model secara brutal, tim peneliti Alibaba melakukan pembaruan struktural pada tiga bagian inti arsitektur sparse MoE milik Qwen4-Max:
Kombinasi Gated DeltaNet (GDN) dan Qwen Sparse Attention (QSA): Setiap satu lapisan QSA kini dipasangkan dengan tiga lapisan Gated DeltaNet yang bertugas memadatkan riwayat percakapan panjang menjadi status berukuran tetap (fixed-size states). Mekanisme QSA kemudian menggunakan pengindeks ringan untuk memilih potongan konteks relevan pada tingkat blok mikro, sehingga biaya komputasi tetap rendah meskipun jendela konteks mencapai 1 juta token.
Gated Residual (GR): Empat jalur residual paralel dilengkapi gerbang baca dan tulis dinamis (
). Perubahan ini memperkuat aliran informasi antar-lapisan dan mencegah lonjakan
loss
(
loss spikes
) selama pelatihan skala triliunan parameter.
N-gram Embedding 328 Miliar Parameter: Alibaba menambahkan 328 miliar parameter khusus di lapisan kedua untuk pencarian cepat pola token lokal (local token patterns), memberikan kapasitas memori tambahan dengan beban komputasi nyaris nol.
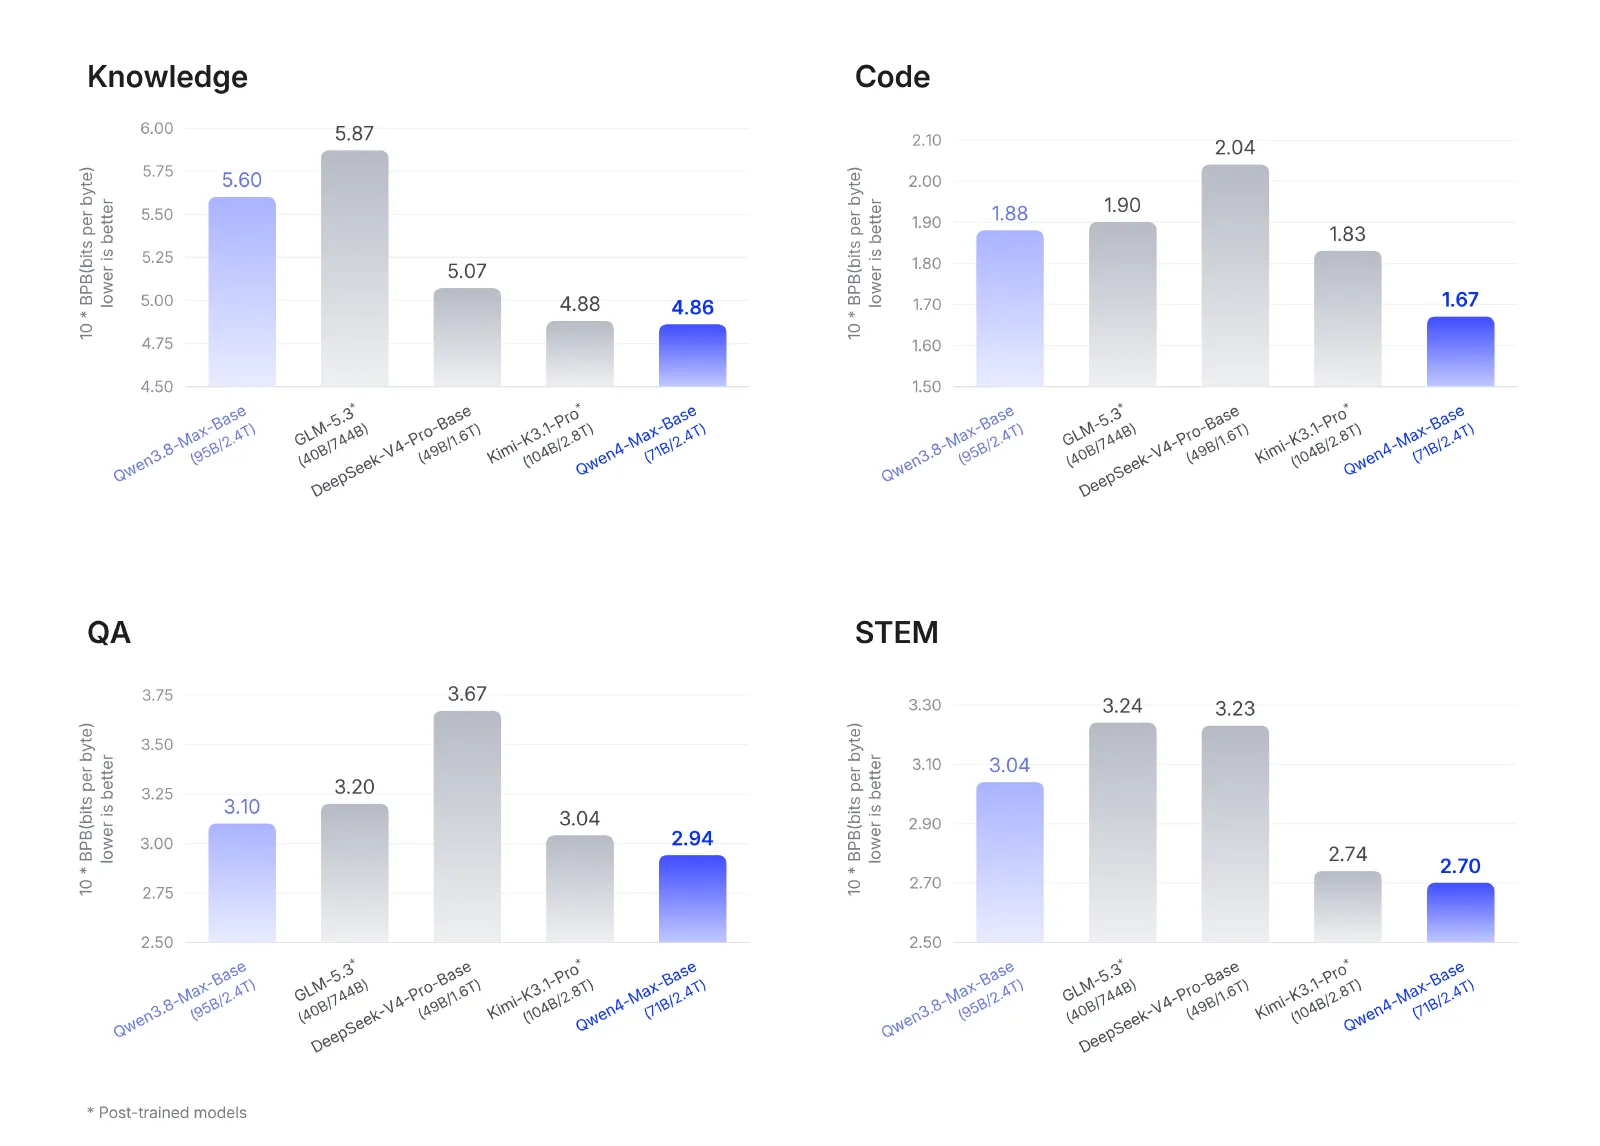
Hasilnya, pada pengujian internal pra-pelatihan (Qwen4-Max-Base), model ini mencatatkan tingkat bits per byte (BPB) 5 hingga 13 persen lebih rendah dibandingkan pendahulunya (Qwen3.8-Max-Base) sembari mengaktifkan seperempat parameter lebih sedikit.
Performa Benchmark dan Skema Harga API Terbaru
Berdasarkan data evaluasi yang dipublikasikan Alibaba serta analisis komparasi dari pengembang pihak ketiga per 16 November 2026, Qwen4-Max unggul kuat pada tugas agen otonom jangka panjang (long-horizon agentic work), meskipun masih tertinggal dari pesaing Barat pada beberapa tolok ukur pemrograman tingkat ekstrem.
Aspek / Tolok UkurQwen4-Max (qwen4-max)Catatan & Perbandingan KompetitorTotal Parameter2,4 Triliun (+ 328B N-gram Embedding)Hanya 71 Miliar parameter aktif per token (turun dari ~95B di Qwen3.8-Max).Kapasitas Konteks & Output1.000.000 token input / 262.144 token output (GA)Mendukung input teks, gambar, dan video; batas output gabungan penalaran (thinking) dan jawaban akhir.Skor Agen Hukum (HLAB-Vals-1.1)21,3 (Peringkat 1)Mengungguli Kimi K3.1 (11,7) dan Claude Opus 5.5 (9,2).Skor Agen Umum (Agents' Last Exam)46,7 (Peringkat 1)Mengungguli Claude Opus 5.5 (43,4) dan Kimi K3.1 (43,4).Produktivitas (Work360)52,69 (naik dari 47,74)Konsumsi token turun hingga 35–49% pada tugas berat, memangkas biaya rata-rata per tugas dari US$ 4,43 menjadi US$ 1,67.Catatan Kelemahan TeknisProgramBench: 31,5 / Terminal-Bench 4.0: 48,5%Masih berada di belakang Claude Opus 5.5 (65,0) dan Kimi K3.1 Pro (67,2%) pada tugas replikasi kode kompleks.Tarif API (Wilayah Singapura)US$ 1,50 input / US$ 4,50 output per 1 juta tokenPembacaan cache (cache reads) anjlok 70% menjadi US$ 0,075 per juta token (wilayah global lain lebih murah lagi di US$ 1,413 / US$ 4,24).
Catatan Kritis bagi Pengembang: Tidak Open-Weight dan Perubahan Batas Output
Di tengah antusiasme atas efisiensi biayanya, komunitas sumber terbuka (open-source) menyoroti satu keputusan strategis Alibaba: Qwen4-Max dirilis sebagai model tertutup (proprietary / API-only). Pengembang tidak dapat mengunduh bobot model (weights) untuk dijalankan secara mandiri di server lokal, meskipun Alibaba berjanji akan merilis varian Qwen4 berukuran lebih kecil dengan lisensi open-weight di kemudian hari.
Selain itu, pengembang yang sudah mengintegrasikan versi pratinjau sejak pekan lalu wajib memperhatikan dua perubahan teknis yang mulai berlaku hari ini:
Migrasi ID Model Sebelum 25 November: Model pratinjau qwen4-max-preview akan resmi dipensiunkan pada 25 November 2026 pukul 24.00 (UTC+8). Aplikasi produksi harus segera dialihkan ke ID resmi qwen4-max.
Pemangkasan Kuota Output Gabungan: Pada versi GA, batas maksimal token output gabungan (thinking + jawaban akhir) disesuaikan menjadi 262.144 token (turun sepertiga dari 393.216 token saat pratinjau). Mengingat mode penalaran (thinking mode) aktif secara bawaan, pengembang disarankan mengatur parameter tingkat upaya penalaran (effort level) secara cermat agar kuota token tidak habis sebelum jawaban akhir selesai ditulis.
Offloop AI Benchmarks — What Is Qwen 4? Qwen4-Max Benchmarks, Real-World Tests, and API Pricing (16 November 2026): https://offloop.org/learn/qwen-4-max
Google Buka Fitur /teamwork di Antigravity: Arsitektur Multi-Agen yang Memformalkan 1,8 Juta Baris Bukti Matematika LeanSelama beberapa tahun terakhir, perdebatan di komunitas kecerdasan buatan (AI) sering terjebak pada satu pertanyaan: seberapa besar jendela konteks (context window) dan parameter…15 November 2026
 BANDUNG QUALITY